Redux 基础教程, 第七节: RTK Query 基础
你将学到
- RTK Query 如何简化 Redux 应用程序的数据获取
- 如何设置 RTK Query
- 如何使用 RTK Query 进行基本的数据获取和更新请求
预置知识
- 完成本教程前面部分以了解 Redux Toolkit 使用模式
Introduction
在 第 5 部分:异步逻辑和数据获取 和 第 6 部分:性能和规范化,我们看到了 用于使用 Redux 获取和缓存数据的标准模式。这些模式包括使用异步 thunk 来获取数据、使用结果 dispatch 操作、管理存储中的请求加载状态以及规范化缓存数据以更轻松地通过 ID 查找和更新单个项目。
在本节中,我们将了解如何使用 RTK Query,这是一种专为 Redux 应用程序设计的数据获取和缓存解决方案,并了解它如何简化获取数据并在我们的组件中使用它的过程。
RTK Query 概述
RTK Query 是一个强大的数据获取和缓存工具。它旨在简化在 Web 应用程序中加载数据的常见情况,无需自己手动编写数据获取和缓存逻辑。
RTK Query 是一个包含在 Redux Toolkit 包中的可选插件,其功能构建在 Redux Toolkit 中的其他 API 之上。
动机
Web 应用程序通常需要从服务器获取数据才能显示它。他们通常还需要对该数据进行更新,将这些更新发送到服务器,并使客户端上的缓存数据与服务器上的数据保持同步。由于需要实现当今应用程序中使用的其他行为,这变得更加复杂:
- 跟踪加载状态以显示 UI 微调器
- 避免对相同数据的重复请求
- Optimistic updates to make the UI feel faster
- 在用户与 UI 交互时管理缓存生命周期
我们已经看到了如何使用 Redux Toolkit 实现这些行为。
然而,从历史上看,Redux 从来没有内置任何东西来帮助 完全 解决这些用例。即使我们将 createAsyncThunk 与 createSlice 一起使用,在发出请求和管理加载状态方面仍然需要进行大量手动工作。我们必须创建异步 thunk,发出实际请求,从响应中提取相关字段,添加加载状态字段,在 extraReducers 中添加处理程序以处理 pending/fulfilled/rejected 情况,并实际编写正确的状态更新。
在过去的几年里,React 社区已经意识到 “数据获取和缓存” 实际上是一组不同于 “状态管理” 的关注点。虽然你可以使用 Redux 之类的状态管理库来缓存数据,但用例差异较大,因此值得使用专门为数据获取用例构建的工具。
RTK Query 从其他开创数据获取解决方案的工具中汲取灵感,例如 Apollo Client、React Query、Urql 和 SWR,但在其 API 设计中添加了独特的方法:
- 数据获取和缓存逻辑构建在 Redux Toolkit 的
createSlice和createAsyncThunkAPI 之上 - 由于 Redux Toolkit 与 UI 无关,因此 RTK Query 的功能可以与任何 UI 层一起使用
- API 请求接口是提前定义的,包括如何从参数生成查询参数和转换响应以进行缓存
- RTK Query 还可以生成封装整个数据获取过程的 React hooks ,为组件提供
data和isFetching字段,并在组件挂载和卸载时管理缓存数据的生命周期 - RTK Query 提供“缓存数据项生命周期函数”选项,支持在获取初始数据后通过 websocket 消息流式传输缓存更新等用例
- 我们有从 OpenAPI 和 GraphQL 模式生成 API slice 代码的早期工作示例
- 最后,RTK Query 完全用 TypeScript 编写,旨在提供出色的 TS 使用体验
包含
APIs
RTK Query 包含在核心 Redux Toolkit 包的安装中。它可以通过以下两个入口点之一获得:
import { createApi } from '@reduxjs/toolkit/query'

/* 自动生成的特定于 React 的入口点
    对应于定义请求接口的 hooks  */
import { createApi } from '@reduxjs/toolkit/query/react'
RTK Query 主要由两个 API 组成:
createApi():RTK Query 功能的核心。它允许你定义一组请求接口来描述如何从一系列请求接口检索数据,包括如何获取和转换该数据的配置。在大多数情况下,你应该在每个应用程序中使用一次,根据经验,“每个基本 URL 一个 API slice”。fetchBaseQuery():fetch的一个小包装 -US/docs/Web/API/Fetch_API),旨在简化请求。旨在为大多数用户在createApi中使用推荐的baseQuery。
Bundle 大小
RTK Query 将固定的一次性数量添加到应用程序的捆绑包大小。由于 RTK Query 构建在 Redux Toolkit 和 React-Redux 之上,因此增加的大小取决于你是否已经在应用程序中使用它们。估计的 min+gzip 包大小为:
- 如果你已经在使用 RTK:~9kb 用于 RTK Query,~2kb 用于hooks。
- 如果你尚未使用 RTK:
- 没有 React:17 kB 用于 RTK+依赖项+RTK Query
- 使用 React:19kB + React-Redux,这是一个对等依赖项
添加额外的请求接口定义应该只根据请求接口定义中的实际代码增加大小,通常只有几个字节。
RTK Query 中包含的功能可以快速支付增加的包大小,对于大多数有意义的应用程序来说,消除手写数据获取逻辑应该是大小的净改进。
RTK Query 缓存的设计思想
Redux 一直强调可预测性和显式行为。Redux 没有“魔法”——你应该能够理解应用程序中发生了什么,因为所有 Redux 逻辑都遵循相同的基本模式,即通过 reducers 调度操作和更新状态。这确实意味着有时你必须编写更多代码才能使事情发生,但权衡是应该非常清楚数据流和行为是什么。
Redux Toolkit 核心 API 不会更改 Redux 应用程序中的任何基本数据流 你仍在调度操作和编写 reducer,只是代码比手动编写所有逻辑要少。 RTK Query 同理。这是一个额外的抽象级别,但在内部,它仍在执行我们已经看到的用于管理异步请求及其响应的完全相同的步骤。
但是,当你使用 RTK Query 时,会发生思维转变。我们不再考虑“管理状态”本身。相反,我们现在考虑“管理缓存数据”。与其尝试自己编写 reducer,我们现在将专注于定义 “这些数据来自哪里?”、“这个更新应该如何发送?”、“这个缓存的数据应该什么时候重新获取?”,以及“缓存的数据应该如何更新?”。如何获取、存储和检索这些数据成为我们不再需要担心的实现细节。
随着我们的继续,将看到这种思维方式的转变如何应用。
设置 RTK Query
我们的示例应用程序已经可以运行,但现在是时候迁移所有异步逻辑以使用 RTK Query 了。随着我们的学习,我们将看到如何使用 RTK Query 的所有主要功能,以及如何迁移现有的 createAsyncThunk 和 createSlice 使用以使用 RTK Query API。
定义 API Slice
以前,我们为每个不同的数据类型(如帖子、用户和通知)定义了单独的 “Slice”。每个 Slice 都有自己的 reducer,定义自己的操作和 thunk,并分别缓存该数据类型的条目。
使用 RTK Query,管理缓存数据的逻辑被集中到每个应用程序的单个“API Slice”中。就像每个应用程序只有一个 Redux 存储一样,我们现在有一个Slice 用于 所有 我们的缓存数据。
我们将从定义一个新的 apiSlice.js 文件开始。由于这不是特定于我们已经编写的任何其他“功能”,我们将添加一个新的 features/api/ 文件夹并将 apiSlice.js 放在那里。让我们填写 API Slice 文件,然后分解里面的代码,看看它在做什么:
// 从特定于 React 的入口点导入 RTK Query 方法
import { createApi, fetchBaseQuery } from '@reduxjs/toolkit/query/react'

// 定义我们的单个 API Slice 对象
export const apiSlice = createApi({
  // 缓存减速器预计将添加到 `state.api` (已经默认 - 这是可选的)
  reducerPath: 'api',
  // 我们所有的请求都有以 “/fakeApi” 开头的 URL
  baseQuery: fetchBaseQuery({ baseUrl: '/fakeApi' }),
  // “endpoints” 代表对该服务器的操作和请求
  endpoints: builder => ({
    // `getPosts` endpoint 是一个返回数据的 “Query” 操作
    getPosts: builder.query({
      // 请求的 URL 是“/fakeApi/posts”
      query: () => '/posts'
    })
  })
})

// 为 `getPosts` Query endpoint 导出自动生成的 hooks
export const { useGetPostsQuery } = apiSlice
RTK Query 的功能基于一个名为 “createApi” 的方法。到目前为止,我们看到的所有 Redux Toolkit API 都与 UI 无关,并且可以与 任意 UI 层一起使用。RTK Query 核心逻辑也是同理。但是,RTK Query 还包含一个特定于 React 的版本的 createApi,由于我们同时使用 RTK 和 React,我们需要使用它来利用 RTK 的 React 集成。因此,我们专门从 '@reduxjs/toolkit/query/react' 导入。
tip
你的应用程序中应该只有一个 createApi 调用。这一 API Slice 应包含与同一基本 URL 对话的 所有 请求接口定义。例如,请求接口 /api/posts 和 /api/users 都从同一个服务器获取数据,因此它们将进入同一个 API slice。如果你的应用确实从多个服务器获取数据,你可以在每个请求接口中指定完整的 URL,或者在必要时为每个服务器创建单独的 API slice。
请求接口通常直接在 createApi 调用中定义。如果你希望在多个文件之间拆分请求接口,请参阅文档的 第 8 部分中的“注入请求接口”部分 部分!
API Slice 参数
当我们调用 createApi 时,需要两个字段:
baseQuery:一个知道如何从服务器获取数据的函数。RTK Query 包括fetchBaseQuery,一个围绕标准fetch()函数的小包装器,用于处理请求和响应的典型处理。当我们创建一个fetchBaseQuery实例时,我们可以传入所有未来请求的基本 URL,以及覆盖修改请求标头等行为。endpoints:我们为与此服务器交互而定义的一组操作。请求接口可以是 queries,它返回用于缓存的数据,或者是 mutations,它向服务器发送更新。 请求接口是使用回调函数定义的,该函数接受builder参数并返回一个对象,该对象包含使用builder.query()和builder.mutation()创建的请求接口定义。
createApi 还接受一个 reducerPath 字段,它为生成的 reducer 定义了预期的顶级状态 slice 字段。对于我们的其他 slice,如postsSlice,不能保证它会用于更新state.posts - 我们 可以 已将 reducer 附加到根状态的任何位置,例如someOtherField:postsReducer。在这里,createApi 期望我们告诉它,当我们将缓存减速器添加到存储时,缓存状态将存在于何处。如果不提供 reducerPath 选项,则默认为 'api',因此你的所有 RTKQ 缓存数据都将存储在 state.api 下。
如果你忘记将 reducer 添加到 store,或者将其附加到与 reducerPath 中指定的键不同的键上,RTKQ 将记录一个错误,让你知道这需要修复。
定义 Endpoints
所有请求的 URL 的第一部分在 fetchBaseQuery 定义中定义为 '/fakeApi'。
第一步,我们要添加一个请求接口,该请求接口将返回来自假 API 服务器的整个帖子列表。我们将包含一个名为 getPosts 的请求接口,并使用 builder.query() 将其定义为 query endpoint。此方法接受许多选项来配置如何发出请求和处理响应。现在,我们需要做的就是通过定义一个 query 选项来提供 URL 路径的剩余部分,并带有一个返回 URL 字符串的回调:() => '/posts'。
默认情况下,查询请求接口将使用 GET HTTP 请求,但你可以通过返回类似 {url: '/posts', method: 'POST', body: newPost} 的对象来覆盖它,而不仅仅是 URL 字符串 本身。你还可以通过这种方式为请求定义几个其他选项,例如设置标头。
导出 API Slice 和 Hooks
在我们之前的 slice 文件中,我们只是导出了 action creators 和 slice reducers,因为其他文件中只需要这些。使用 RTK Query,我们通常会导出整个 API slice 对象本身,因为它有几个可能有用的字段。
最后,仔细查看这个文件的最后一行。这个 useGetPostsQuery 值来自哪里?
RTK Query 的 React 集成会自动为我们定义的 每个 请求接口生成 React hooks! 这些 hooks 封装了在组件挂载时触发请求的过程,以及在处理请求和数据可用时重新渲染组件的过程。我们可以从这个 API slice 文件中导出这些 hooks,以便在我们的 React 组件中使用。
hooks 根据标准约定自动命名:
use,任何 React hooks 的正常前缀- 请求接口名称,大写
- 请求接口的类型,
Query或Mutation
在这种情况下,我们的请求接口是 getPosts,它是一个查询请求接口,所以生成的 hooks 是 useGetPostsQuery。
配置 Store
我们现在需要将 API Slice 连接到我们的 Redux 存储。我们可以修改现有的 store.js 文件,将 API slice 的 cache reducer 添加到状态中。此外,API slice 会生成需要添加到 store 的自定义 middleware。这个 middleware 必须 被添加——它管理缓存的生命周期和控制是否过期。
import postsReducer from '../features/posts/postsSlice'
import usersReducer from '../features/users/usersSlice'
import notificationsReducer from '../features/notifications/notificationsSlice'
import { apiSlice } from '../features/api/apiSlice'

export default configureStore({
  reducer: {
    posts: postsReducer,
    users: usersReducer,
    notifications: notificationsReducer,
    [apiSlice.reducerPath]: apiSlice.reducer
  },
  middleware: getDefaultMiddleware =>
    getDefaultMiddleware().concat(apiSlice.middleware)
})
我们可以在 reducer 参数中重用 apiSlice.reducerPath 字段作为计算键,以确保在正确的位置添加缓存 reducer。
我们需要在 store 设置中保留所有现有的标准 middleware,例如“redux-thunk”,而 API slice 的 middleware 通常会在这些 middleware 之后使用。我们可以通过向 configureStore 提供 middleware 参数,调用提供的 getDefaultMiddleware() 方法,并在返回的 middleware 数组的末尾添加 apiSlice.middleware 来做到这一点。
显示带有查询的帖子
在组件中使用 Query Hooks
现在我们已经定义了 API slice 并将其添加到 store 中,我们可以将生成的 useGetPostsQuery hooks 导入我们的 <PostsList> 组件并在那里使用它。
目前,<PostsList> 专门导入 useSelector、useDispatch 和 useEffect,从存储中读取帖子数据和加载状态,并在 mount 时调度 fetchPosts() thunk 以触发数据获取。 useGetPostsQueryHook 取代了所有这些!
让我们看看使用这个 hooks时 <PostsList> 的样子:
import React from 'react'
import { Link } from 'react-router-dom'

import { Spinner } from '../../components/Spinner'
import { PostAuthor } from './PostAuthor'
import { TimeAgo } from './TimeAgo'
import { ReactionButtons } from './ReactionButtons'

import { useGetPostsQuery } from '../api/apiSlice'

let PostExcerpt = ({ post }) => {
  return (
    <article className="post-excerpt" key={post.id}>
      <h3>{post.title}</h3>
      <div>
        <PostAuthor userId={post.user} />
        <TimeAgo timestamp={post.date} />
      </div>
      <p className="post-content">{post.content.substring(0, 100)}</p>

      <ReactionButtons post={post} />
      <Link to={`/posts/${post.id}`} className="button muted-button">
        View Post
      </Link>
    </article>
  )
}

export const PostsList = () => {
  const {
    data: posts,
    isLoading,
    isSuccess,
    isError,
    error
  } = useGetPostsQuery()

  let content

  if (isLoading) {
    content = <Spinner text="Loading..." />
  } else if (isSuccess) {
    content = posts.map(post => <PostExcerpt key={post.id} post={post} />)
  } else if (isError) {
    content = <div>{error.toString()}</div>
  }

  return (
    <section className="posts-list">
      <h2>Posts</h2>
      {content}
    </section>
  )
}
从概念上讲,<PostsList> 仍然在做与以前一样的工作,但我们能够用对 useGetPostsQuery() 的单个调用来替换多个 useSelector 调用和 useEffect 调度。
每个生成的 Query hooks 都会返回一个包含多个字段的“结果”对象,包括:
data:来自服务器的实际响应内容。 在收到响应之前,该字段将是 “undefined”。isLoading: 一个 boolean,指示此 hooks 当前是否正在向服务器发出 第一次 请求。(请注意,如果参数更改以请求不同的数据,isLoading将保持为 false。)isFetching: 一个 boolean,指示 hooks 当前是否正在向服务器发出 any 请求isSuccess: 一个 boolean,指示 hooks 是否已成功请求并有可用的缓存数据(即,现在应该定义 data)isError: 一个 boolean,指示最后一个请求是否有错误error: 一个 serialized 错误对象
从结果对象中解构字段是很常见的,并且可能将 data 重命名为更具体的变量,例如 posts 来描述它包含的内容。然后我们可以使用状态 boolean 和 data/error 字段来呈现我们想要的 UI。 但是,如果你使用的是 TypeScript,你可能需要保持原始对象不变,并在条件检查中将标志引用为 result.isSuccess,以便 TS 可以正确推断 data 是有效的。
以前,我们从 store 中选择一个帖子 ID 列表,将一个帖子 ID 传递给每个 <PostExcerpt> 组件,然后分别从 store 中选择每个单独的 Post 对象。由于 posts 数组已经包含了所有的 post 对象,我们已经切换回将 post 对象本身作为 props 向下传递。
帖子排序
不幸的是,这些帖子现在显示不正确。以前,我们使用 createEntityAdapter 的排序选项在 reducer 级别按日期对它们进行排序。由于 API slice 只是缓存从服务器返回的确切数组,因此不会发生特定的排序 - 服务器发回的任何顺序都是我们得到的。
有几个不同的选择可以处理这个问题。现在,我们将在 <PostsList> 本身内部进行排序,稍后我们将讨论其他选项及其权衡。
我们不能直接调用 posts.sort(),因为 Array.sort() 会改变现有数组,所以我们需要先复制它。为了避免在每次重新渲染时重新排序,我们可以在 useMemo() hooks 中进行排序。 我们还想给posts一个默认的空数组,以防它是undefined,这样我们总是有一个数组可以排序。
// omit setup

export const PostsList = () => {
  const {
    data: posts = [],
    isLoading,
    isSuccess,
    isError,
    error
  } = useGetPostsQuery()

  const sortedPosts = useMemo(() => {
    const sortedPosts = posts.slice()
    // Sort posts in descending chronological order
    sortedPosts.sort((a, b) => b.date.localeCompare(a.date))
    return sortedPosts
  }, [posts])

  let content

  if (isLoading) {
    content = <Spinner text="Loading..." />
  } else if (isSuccess) {
    content = sortedPosts.map(post => <PostExcerpt key={post.id} post={post} />)
  } else if (isError) {
    content = <div>{error.toString()}</div>
  }

  return (
    <section className="posts-list">
      <h2>Posts</h2>
      {content}
    </section>
  )
}
显示单个帖子
我们更新了<PostsList> 以获取 所有 帖子的列表,并且我们在列表中显示了每个 Post 的片段。但是,如果我们点击其中任何一个的 “查看帖子”,我们的 <SinglePostPage> 组件将无法在旧的 state.posts slice 中找到帖子,并向我们显示 “找不到帖子!” 错误。我们还需要更新 <SinglePostPage> 以使用 RTK Query。
我们有几种方法可以做到这一点。一种方法是让 <SinglePostPage> 调用相同的 useGetPostsQuery() hooks ,获取 整个 帖子数组,然后只找到它需要显示的一个 Post 对象。Query hooks 还有一个 selectFromResult 选项,它允许我们在 hooks 本身内部更早地进行相同的查找 - 我们稍后会看到这一点。
相反,我们将尝试添加另一个请求接口定义,让我们根据其 ID 从服务器请求单个帖子。 这有点多余,但它可以让我们看到如何使用 RTK Query 来自定义基于参数的查询请求。
添加单个 Post Query 请求接口
在 apiSlice.js 中,我们将添加另一个查询请求接口定义,称为 getPost(这次没有 's'):
export const apiSlice = createApi({
  reducerPath: 'api',
  baseQuery: fetchBaseQuery({ baseUrl: '/fakeApi' }),
  endpoints: builder => ({
    getPosts: builder.query({
      query: () => '/posts'
    }),
    getPost: builder.query({
      query: postId => `/posts/${postId}`
    })
  })
})

export const { useGetPostsQuery, useGetPostQuery } = apiSlice
getPost 请求接口看起来很像现有的 getPosts 请求接口,但 query 参数不同。 在这里,query 接受一个名为 postId 的参数,我们使用该 postId 来构造服务器 URL。 这样我们就可以只对一个特定的 Post 对象发出服务器请求。
这也会生成一个新的 useGetPostQuery hooks,因此我们也将其导出。
查询参数和缓存键
我们的 <SinglePostPage> 当前正在根据 ID 从 state.posts 中读取一个 Post 条目。 我们需要更新它以调用新的 useGetPostQuery hooks ,并使用与主列表类似的加载状态。
import React from 'react'
import { Link } from 'react-router-dom'

import { Spinner } from '../../components/Spinner'
import { useGetPostQuery } from '../api/apiSlice'

import { PostAuthor } from './PostAuthor'
import { TimeAgo } from './TimeAgo'
import { ReactionButtons } from './ReactionButtons'

export const SinglePostPage = ({ match }) => {
  const { postId } = match.params

  const { data: post, isFetching, isSuccess } = useGetPostQuery(postId)

  let content
  if (isFetching) {
    content = <Spinner text="Loading..." />
  } else if (isSuccess) {
    content = (
      <article className="post">
        <h2>{post.title}</h2>
        <div>
          <PostAuthor userId={post.user} />
          <TimeAgo timestamp={post.date} />
        </div>
        <p className="post-content">{post.content}</p>
        <ReactionButtons post={post} />
        <Link to={`/editPost/${post.id}`} className="button">
          Edit Post
        </Link>
      </article>
    )
  }

  return <section>{content}</section>
}
请注意,我们正在获取从路由器匹配中读取的postId,并将其作为参数传递给useGetPostQuery。 然后 Query hooks 将使用它来构造请求 URL,并获取这个特定的 Post 对象。
那么,所有这些数据是如何被缓存的呢? 让我们点击“查看帖子”查看我们的一个帖子条目,然后看看此时 Redux 存储中的内容。
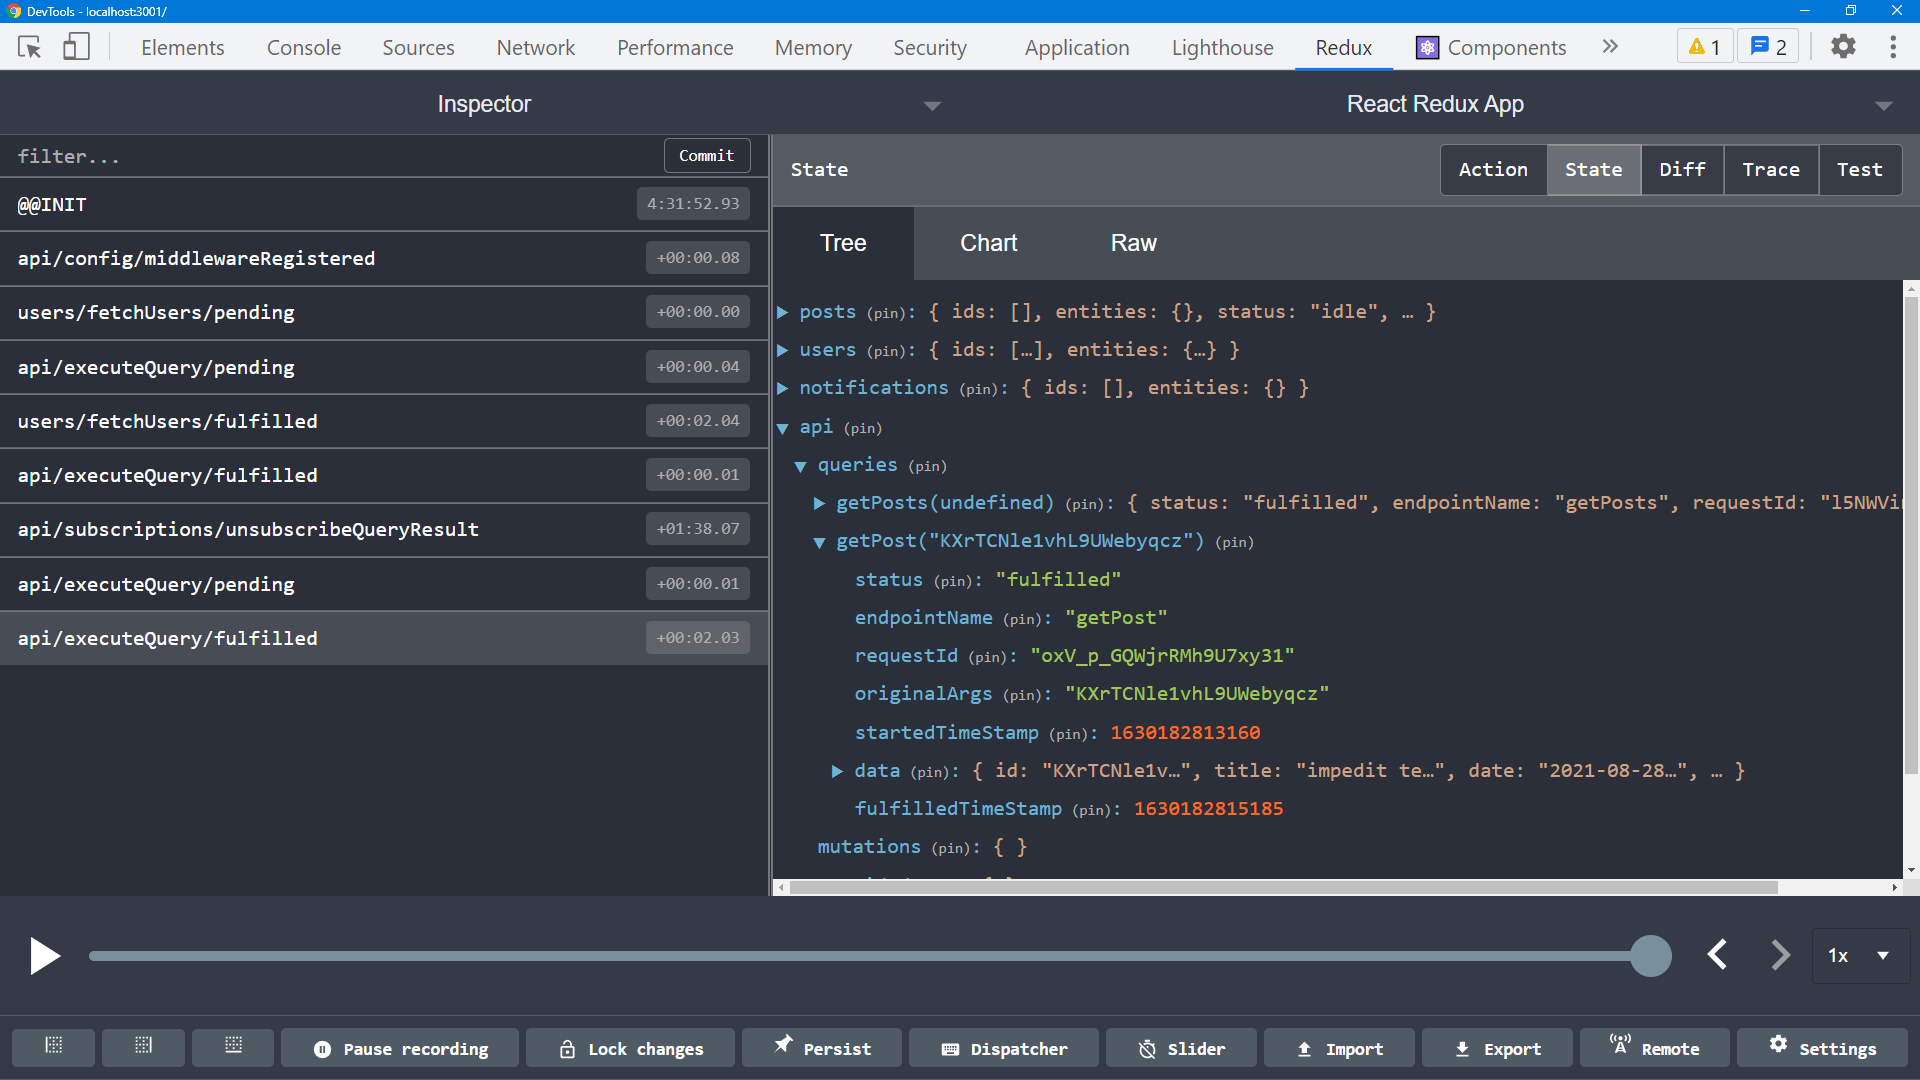
我们可以看到我们有一个顶级的 state.api slice ,正如商店设置中所预期的那样。里面有一个叫做 “Query” 的部分,它目前有两个项目。 键 getPosts(undefined) 表示我们使用 getPosts 请求接口发出的请求的元数据和响应内容。 同样,键 getPost('abcd1234') 是针对我们刚刚为这篇文章提出的特定请求。
RTK Query 为每个唯一的请求接口 + 参数组合创建一个 “cache key”,并分别存储每个 cache key 的结果。这意味着你可以多次使用同一个 Query hooks ,传递不同的查询参数,每个结果将单独缓存在 Redux 存储中。
还需要注意的是查询参数必须是 单一 值!如果需要传递多个参数,则必须传递一个包含多个字段的对象(与createAsyncThunk完全相同)。 RTK Query 将对字段进行浅稳定比较,如果其中任何一个发生更改,则重新获取数据。
请注意,左侧列表中的操作名称更加通用且描述性更少:api/executeQuery/fulfilled,而不是posts/fetchPosts/fulfilled。 这是使用附加抽象层的权衡。 各个动作确实包含在 “action.meta.arg.endpointName” 下的特定请求接口名称,但它在 action 历史列表中并不容易查看。
tip
Redux 团队正在为 Redux DevTools 开发一个新的 RTK Query 视图,它将专门以更可用的格式显示 RTK Query 数据。 这包括每个请求接口和缓存结果的信息、查询时间的统计信息等等。 这将在不久的将来添加到 DevTools 扩展中。 有关预览,请参阅:
创建带有 Mutations 的帖子
我们已经看到了如何通过定义查询请求接口从服务器获取数据,但是向服务器发送更新呢?
RTK Query 让我们定义 mutation 请求接口 来更新服务器上的数据。让我们添加一个可以让我们添加新帖子的 Mutation。
添加新的 Mutations 后请求接口
添加 Mutation 请求接口与添加查询请求接口非常相似。 最大的不同是我们使用 builder.mutation() 而不是 builder.query() 来定义请求接口。 此外,我们现在需要将 HTTP 方法更改为“POST”请求,并且我们还必须提供请求的正文。
export const apiSlice = createApi({
  reducerPath: 'api',
  baseQuery: fetchBaseQuery({ baseUrl: '/fakeApi' }),
  endpoints: builder => ({
    getPosts: builder.query({
      query: () => '/posts'
    }),
    getPost: builder.query({
      query: postId => `/posts/${postId}`
    }),
    addNewPost: builder.mutation({
      query: initialPost => ({
        url: '/posts',
        method: 'POST',
        // Include the entire post object as the body of the request
        body: initialPost
      })
    })
  })
})

export const {
  useGetPostsQuery,
  useGetPostQuery,
  useAddNewPostMutation
} = apiSlice
这里我们的 query 选项返回一个包含 {url, method, body} 的对象。 由于我们使用 fetchBaseQuery 来发出请求,body 字段将自动为我们进行 JSON 序列化。
与查询请求接口一样,API slice 会自动为 Mutation 请求接口生成一个 React hooks - 在本例中为 useAddNewPostMutation。
在组件中使用 Mutation Hooks
每当我们单击“保存帖子”按钮时,我们的 <AddPostForm> 已经调度了一个异步 thunk 来添加帖子。 为此,它必须导入 useDispatch 和 addNewPost thunk。 Mutation hooks 取代了这两者,并且使用模式非常相似。
import React, { useState } from 'react'
import { useSelector } from 'react-redux'

import { Spinner } from '../../components/Spinner'
import { useAddNewPostMutation } from '../api/apiSlice'
import { selectAllUsers } from '../users/usersSlice'

export const AddPostForm = () => {
  const [title, setTitle] = useState('')
  const [content, setContent] = useState('')
  const [userId, setUserId] = useState('')

  const [addNewPost, { isLoading }] = useAddNewPostMutation()
  const users = useSelector(selectAllUsers)

  const onTitleChanged = e => setTitle(e.target.value)
  const onContentChanged = e => setContent(e.target.value)
  const onAuthorChanged = e => setUserId(e.target.value)

  const canSave = [title, content, userId].every(Boolean) && !isLoading

  const onSavePostClicked = async () => {
    if (canSave) {
      try {
        await addNewPost({ title, content, user: userId }).unwrap()
        setTitle('')
        setContent('')
        setUserId('')
      } catch (err) {
        console.error('Failed to save the post: ', err)
      }
    }
  }

  // omit rendering logic
}
Mutation hooks 返回一个包含两个值的数组:
- 第一个值是触发函数。当被调用时,它会使用你提供的任何参数向服务器发出请求。这实际上就像一个已经被包装以立即调度自身的 thunk。
- 第二个值是一个对象,其中包含有关当前正在进行的请求(如果有)的元数据。这包括一个
isLoading标志以指示请求是否正在进行中。
我们可以用 useAddNewPostMutation hooks 中的触发函数和 isLoading 标志替换现有的 thunk 调度和组件加载状态,组件的其余部分保持不变。
与 thunk 调度一样,我们使用初始 post 对象调用 addNewPost。 这会返回一个带有 .unwrap() 方法的特殊 Promise ,我们可以 await addNewPost().unwrap() 使用标准的 try/catch 块来处理任何潜在的错误。
刷新缓存数据
当我们点击 “Save Post” 时,我们可以在浏览器 DevTools 中查看 Network 选项卡,确认 HTTP POST 请求成功。 但是,如果我们回到那里,新帖子不会出现在我们的<PostsList> 中。我们在内存中仍然有相同的缓存数据。
我们需要告诉 RTK Query 刷新其缓存的帖子列表,以便我们可以看到我们刚刚添加的新帖子。
手动重新获取帖子
第一个选项是手动强制 RTK Query 重新获取给定请求接口的数据。Query hooks 结果对象包含一个 “refetch” 函数,我们可以调用它来强制重新获取。 我们可以暂时将“重新获取帖子”按钮添加到<PostsList>,并在添加新帖子后单击该按钮。
此外,之前我们看到 Query hooks 有一个 isLoading 标志,如果这是第一个数据请求,则为 true,以及一个 isFetching 标志,当 任意 数据请求正在进行时为true . 我们可以查看 isFetching 标志,并在重新获取过程中再次用加载微调器替换整个帖子列表。 但是,这可能有点烦人,而且 - 我们已经拥有所有这些帖子,为什么要完全隐藏它们?
相反,我们可以使现有的帖子列表部分透明以指示数据已过时,但在重新获取发生时保持它们可见。 一旦请求完成,我们就可以恢复正常显示帖子列表。
import React, { useMemo } from 'react'
import { Link } from 'react-router-dom'
import classnames from 'classnames'

// omit other imports and PostExcerpt

export const PostsList = () => {
  const {
    data: posts = [],
    isLoading,
    isFetching,
    isSuccess,
    isError,
    error,
    refetch
  } = useGetPostsQuery()

  const sortedPosts = useMemo(() => {
    const sortedPosts = posts.slice()
    sortedPosts.sort((a, b) => b.date.localeCompare(a.date))
    return sortedPosts
  }, [posts])

  let content

  if (isLoading) {
    content = <Spinner text="Loading..." />
  } else if (isSuccess) {
    const renderedPosts = sortedPosts.map(post => (
      <PostExcerpt key={post.id} post={post} />
    ))

    const containerClassname = classnames('posts-container', {
      disabled: isFetching
    })

    content = <div className={containerClassname}>{renderedPosts}</div>
  } else if (isError) {
    content = <div>{error.toString()}</div>
  }

  return (
    <section className="posts-list">
      <h2>Posts</h2>
      <button onClick={refetch}>Refetch Posts</button>
      {content}
    </section>
  )
}
如果我们添加一个新帖子,然后单击 “Refetch Posts”,我们现在应该会看到帖子列表半透明几秒钟,然后在顶部添加新帖子重新渲染。
缓存失效自动刷新
有时需要让用户手动单击以重新获取数据,但对于正常使用而言绝对不是一个好的解决方案。
我们知道我们的服务器拥有所有帖子的完整列表,包括我们刚刚添加的帖子。 理想情况下,我们希望我们的应用程序在 Mutation 请求完成后自动重新获取更新的帖子列表。 这样我们就知道我们的客户端缓存数据与服务器所拥有的数据是同步的。
RTK Query 让我们定义查询和 mutations 之间的关系,以启用自动数据重新获取,使用标签。标签是一个字符串或小对象,可让你命名某些类型的数据和缓存的 无效 部分。当缓存标签失效时,RTK Query 将自动重新获取标记有该标签的请求接口。
基本标签使用需要向我们的 API slice 添加三条信息:
- API slice 对象中的根
tagTypes字段,声明数据类型的字符串标签名称数组,例如'Post' - 查询请求接口中的 “providesTags” 数组,列出了一组描述该查询中数据的标签
- Mutation 请求接口中的“invalidatesTags”数组,列出了每次 Mutation 运行时失效的一组标签
我们可以在 API slice 中添加一个名为 'Post' 的标签,让我们在添加新帖子时自动重新获取 getPosts 请求接口:
export const apiSlice = createApi({
  reducerPath: 'api',
  baseQuery: fetchBaseQuery({ baseUrl: '/fakeApi' }),
  tagTypes: ['Post'],
  endpoints: builder => ({
    getPosts: builder.query({
      query: () => '/posts',
      providesTags: ['Post']
    }),
    getPost: builder.query({
      query: postId => `/posts/${postId}`
    }),
    addNewPost: builder.mutation({
      query: initialPost => ({
        url: '/posts',
        method: 'POST',
        body: initialPost
      }),
      invalidatesTags: ['Post']
    })
  })
})
这就是我们所需要的! 现在,如果我们单击 “Save Post”,你应该会看到 <PostsList> 组件在几秒钟后自动变灰,然后在顶部重新渲染新添加的帖子。
请注意,这里的文字字符串 'Post' 没有什么特别之处。 我们可以称它为“Fred”、“qwerty”或其他任何名称。 它只需要在每个字段中使用相同的字符串,以便 RTK Query 知道“当发生这种 Mutation 时,使列出相同标签字符串的所有请求接口无效”。
你的所学
使用 RTK Query,如何管理数据获取、缓存和加载状态的实际细节被抽象出来。 这大大简化了应用程序代码,并让我们专注于对预期应用程序行为的更高级别的关注。 由于 RTK Query 是使用我们已经看到的相同 Redux Toolkit API 实现的,我们仍然可以使用 Redux DevTools 来查看我们的状态随时间的变化。
Summary
- RTK Query 是 Redux Toolkit 中包含的数据获取和缓存解决方案
- RTK Query 为你抽象了管理缓存服务器数据的过程,无需编写加载状态、存储结果和发出请求的逻辑
- RTK Query 建立在 Redux 中使用的相同模式之上,例如异步 thunk
- RTK Query 对每个应用程序使用单个 “API slice”,使用
createApi定义- RTK Query 提供与 UI 无关和特定于 React 的
createApi版本 - API slice 为不同的服务器操作定义了多个“请求接口”
- 如果使用 React 集成,API slice 包括自动生成的 React hooks
- RTK Query 提供与 UI 无关和特定于 React 的
- 查询请求接口允许从服务器获取和缓存数据
- Query Hooks 返回一个 “data” 值,以及加载状态标志
- 查询可以手动重新获取,或者使用标签自动重新获取缓存失效
- Mutation 请求接口允许更新服务器上的数据
- Mutation hooks 返回一个发送更新请求的“触发”函数,以及加载状态
- 触发函数返回一个可以解包并等待的 Promise
下一步
RTK Query 提供可靠的默认行为,但还包括许多用于自定义如何管理请求和使用缓存数据的选项。 在 第 8 节:RTK 查询高级模式 中,我们将了解如何使用这些选项来实现有用的功能,例如 optimistic updates。